Typecast AI
一款具有情感文本转语音功能的AI语音生成器,可以使用超过400个逼真的声音,将文本转换为逼真的语音。
 StoryMem
 是字节跳动和南洋理工大学开源的一个ai多镜头长视频生成工具,主要解决多镜头视频里人物形象和画面风格不连贯的问题。它把现在的单镜头视频扩散模型改成能做多镜头故事片的工具,靠一个视觉记忆库,做出 40 到 60 秒、8 到 12 个镜头的连续故事,角色样子和场景风格不会乱。
技术实现上,StoryMem在Wan2.2模型的基础上,通过微调加入了记忆处理能力。生成时,先创建第一个镜头作为记忆起点,之后每个新镜头都参考之前的记忆内容,并不断更新记忆库,从而保持整体视频的连贯性。
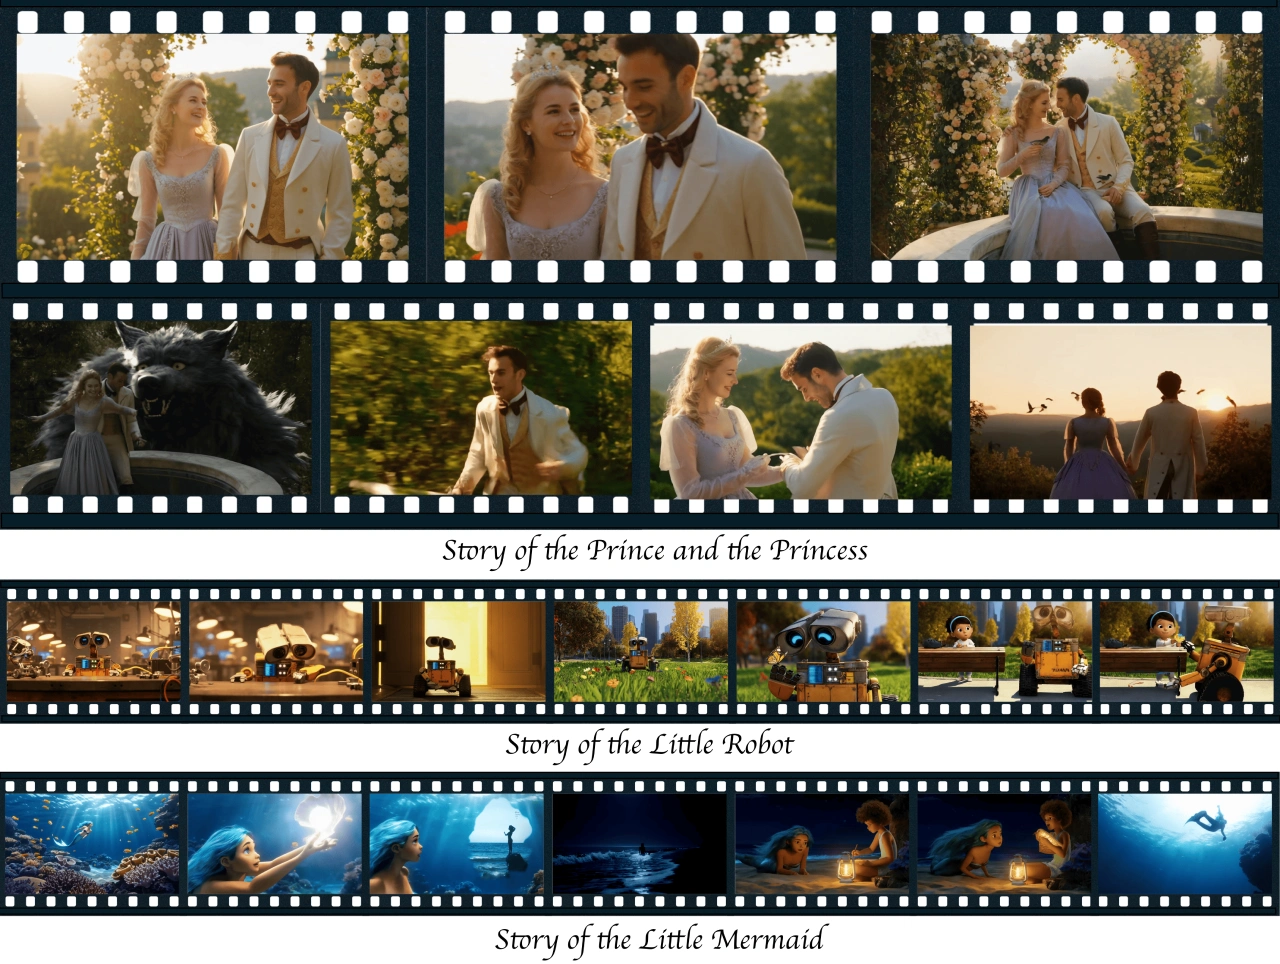
记忆到视频(M2V):用 LoRA 把以前的关键帧放进现在的噪声里,简单调一下就能让不同镜头看着一致。
动态记忆库:最多留 10 张关键帧,先用 CLIP 按意思选,再用 HPSv3 挑好看的,自动去掉差的画面。
三种扩展做法:
MI2V:用第一帧图做条件,转场更顺;
MM2V:用前五帧的动作做条件,动起来更自然;
MR2V:可以上传自己的图当初始记忆,定下主角的脸。
输出效果:和现在的方法比,一致性高了 29%,还保持了原来模型的高画质和对提示的贴合度。
营销广告:输入脚本,很快做出多个动态分镜,方便做 A/B 测试。
影视预制作:把文字故事板直接变成可视的画面,省前期想点子的钱。
短视频 / 独立创作:没门槛也能做出 1 分钟像电影一样的短片。
教育与企业培训:历史重现、科学讲解、产品演示都能一键做出来。
克隆仓库:
git clone https://github.com/Kevin-thu/StoryMem
装依赖:
pip install -r requirements.txt
准备脚本:按例子写好多镜头的提示,或者用 ST-Bench 给的 300 套故事模板。
开始生成:
python inference.py –prompt “你的故事脚本” –length 60 –memory_size 10
可选功能:
要无缝转场就加 –mi2v
要自己定主角就加 –ref_image path/to/face.jpg –mr2v
GitHub: https://github.com/Kevin-thu/StoryMem
论文: https://arxiv.org/abs/2512.19539
模型:
Wan2.2-T2V: https://huggingface.co/Wan-AI/Wan2.2-T2V-A14B
StoryMem LoRA: https://huggingface.co/Kevin-thu/StoryMem
项目主页: https://kevin-thu.github.io/StoryMem/